AI-学Agent到底要学什么
面对层出不穷的 Agent 框架,很多人不知从何下手,也不知道该学什么。直到读了相比层出不穷的 Agent 框架,不变的 Agent Protocol 是什么 一文,作者高屋建瓴地提出 Agent Runtime Protocol 这一概念,才真正理解了 Agent 运行时所必需的底层能力。 本文是该文的读书笔记,也是一份系统学习 Agent 的路径指南。我们先从“Agent 到底在做什么”出发,逐步拆解出核心对象、生命周期操作和八大能力维度,最后给出分阶段的学习建议。
从对话模式到 Runtime 协议#
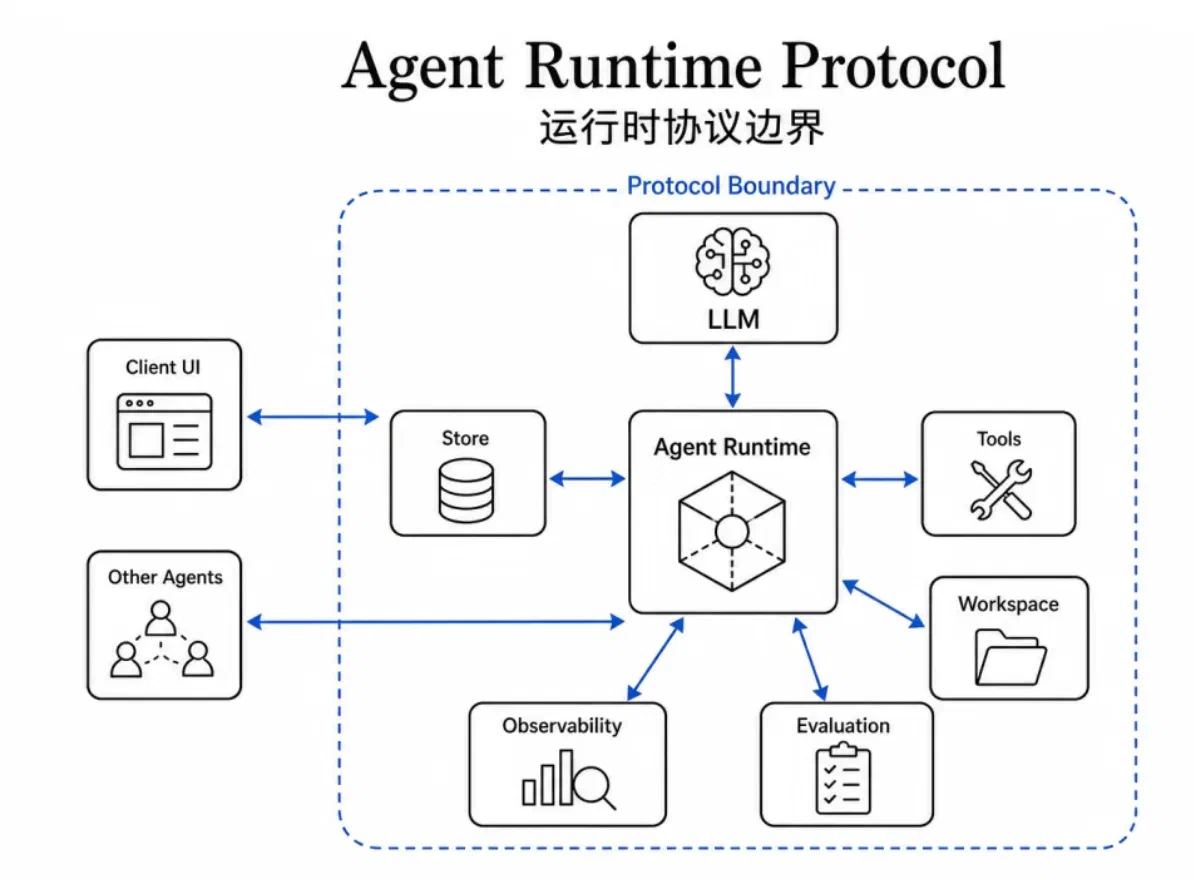 Agent 是一个借助 LLM 技术,通过对话式交互理解人类意图并实现任务目标的工具。既然是对话式交互,Agent 通常有三种模式:
- 一问一答直来直往:用户提问,模型直接回答;
- 先思考再回答(CoT):用户提问后,模型先进行推理,再给出答案;
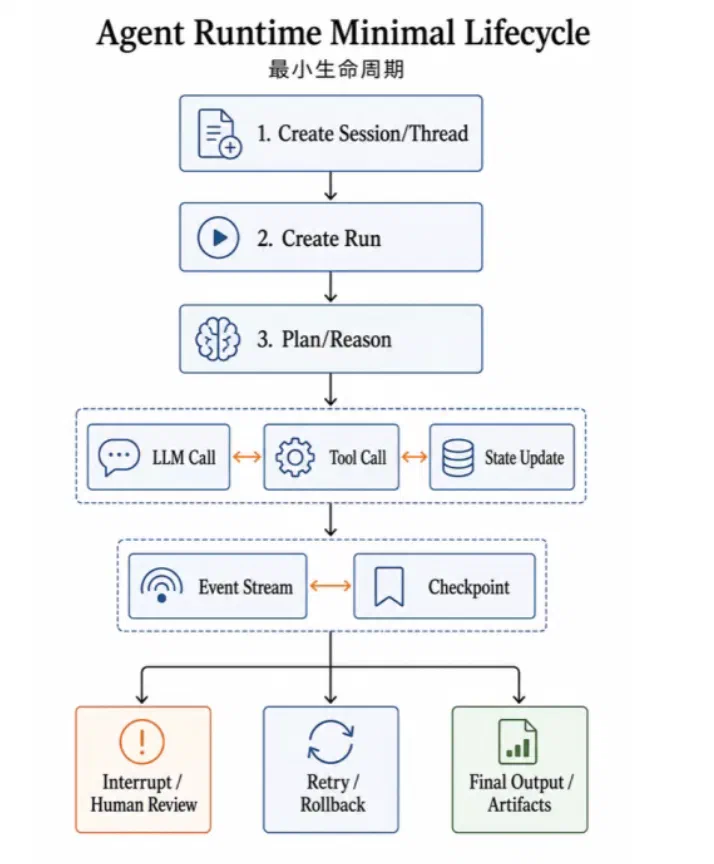
- 先工具后回答(ReAct):收到问题后,先调用工具收集信息、准备上下文,再交给 LLM 推理回答,循环往复,直到 LLM 认为可以给出最终答案。 其中,ReAct 模式是生产级 Agent 最核心的工作方式。它的执行过程包含多次“准备上下文 → 调用 LLM → 执行工具 → 获取反馈”的循环。如果把这一过程抽象到编程层面,就会自然形成一组概念:
- 长期上下文(Thread):承载历史与资源;
- 具体执行(Run):一次任务的生命周期;
- 执行步骤(Step):Run 内的最小可观测单元;
- 事件(Event):实时通知状态变化;
- 检查点(Checkpoint):状态快照,用于失败恢复;
- 产物(Artifact):最终可引用的成果。
此外,整个生命周期还需要支持 interrupt / resume / cancel / retry 等操作,让 Agent 能够暂停、恢复、取消或重试。
Agent Runtime Protocol 是 Agent Runtime 暴露给外部世界的契约。它回答的不是“模型如何思考”,而是:
- 如何启动一次任务:创建 Thread、Task、Run,或发送一条 Message;
- 如何携带上下文:历史消息、文件、结构化数据、参与者、能力声明;
- 如何观察进展:状态变更、流式事件、Artifact 增量、Trace;
- 如何中断和恢复:需要输入、需要授权、取消、重试、继续执行;
- 如何拿到结果:最终消息、Artifact、结构化输出、错误信息。 Agent Runtime 是 Agent 的执行环境,负责:接收输入 → 调用 LLM → 执行工具 → 管理状态 → 产出结果。
一、Agent中的核心概念#
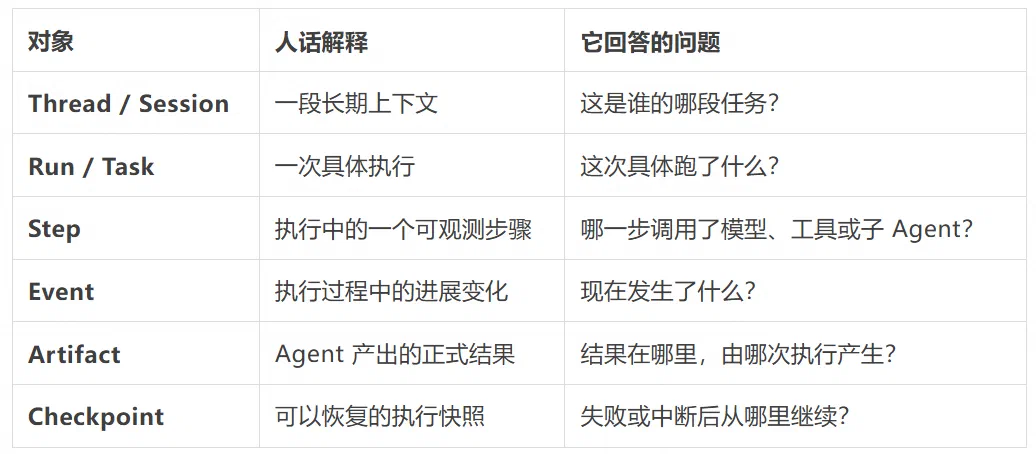
六个核心对象:理解 Agent 的通用语言#
不同框架的 API 千差万别,但底层都在围绕同一组对象打转。把这六个对象吃透,再看任何框架都能快速映射。
1. Thread / Session(线程/会话)#
长期上下文边界,承载历史消息、文件、结构化数据、参与者和记忆。它回答“这是谁的哪段任务”。
例如,你说“帮我做一个 CMS 系统”,后续所有的需求变更、文档上传、讨论都发生在这个 Thread 里,即使过几天回来,上下文依然保留。
2. Run / Task(运行/任务)#
一次具体执行的边界,有明确的开始、进行中和结束状态。它回答“这次具体跑了什么”。
同一个 Thread 内可以有多个 Run:第一次 Run 生成项目骨架,第二次 Run 修改数据库模型,第三次 Run 修复一个 bug。每次 Run 都是独立的一次执行。
3. Step(步骤)#
Run 内部的最小可观测执行单元,比如一次 LLM 推理、一次工具调用、一次消息发送。它回答“哪一步调用了模型或工具”。
在“编写前端页面”这个 Run 里,调用 LLM 生成代码是一个 Step,调用文件写入工具也是一个 Step。通过记录 Step,可以精确知道 Agent 在哪个环节做了什么、耗时多少、输入输出是什么。
4. Event(事件)#
Runtime 向外发出的实时状态变化信号,比如“步骤开始”“工具调用完成”“产物已生成”。它回答“外部如何实时知道 Agent 正在做什么”。
前端界面实时显示“正在生成代码”“文件写入成功”,靠的就是事件流。
5. Artifact(产物)#
Agent 执行产生的可引用成果,如文件、报告、结构化数据。它回答“结果在哪里、由哪次执行产生”。
最终生成的 app.py、database.sql 就是 Artifact,它们会与生成它们的 Run 和 Step 关联,方便追溯。
6. Checkpoint(检查点)#
某个时刻的完整状态快照,包括消息、变量、文件系统变化等。它回答“失败后从哪里继续”。
如果 Agent 执行到第 8 步时崩溃,通过第 7 步完成后的 Checkpoint 可以只重跑第 8 步,而不必重跑前 7 步。这是长任务可靠性的基石。
学习建议:每接触一个新框架,先问自己:“这个框架的 Thread 是什么?Run 怎么表示?Step 怎么记录?事件怎么订阅?Checkpoint 是否存在?” 这样就能迅速抓住框架的本质。
生命周期操作:让 Agent 从“玩具”走向“生产”#
仅仅跑完一个任务不算什么,真正的挑战在于任务可以被安全地暂停、恢复、取消和重试。这四个操作是生产级 Agent 的必备能力。
interrupt(中断)#
主动暂停执行,等待外部输入或审批。中断不是错误,而是合法状态。中断时 Runtime 会保存 Checkpoint 并向外发送事件。
典型场景:工具审批(比如删除数据库前需要人工确认)、需要用户补充信息、到达预设检查点。
resume(恢复)#
外部提供所需信息后,从断点继续执行。必须能精确定位到之前的 Checkpoint,并注入外部输入。
关键是幂等性:同一个恢复请求不应导致重复执行已完成步骤。如果中断后状态已变化(如其他 Run 修改了共享状态),恢复时还需要处理冲突。
cancel(取消)#
外部主动终止一个正在执行或已中断的 Run。取消后任务不再继续,但已产生的副作用(如文件修改)可能需要额外处理。
retry(重试)#
对失败或部分失败的 Run(或 Step)重新执行。可以自动或手动,通常与 Checkpoint 回滚结合,实现局部重试。例如,只在失败的第 8 步重试,而不是从头再来。 学习建议:亲手实现一个支持“暂停-恢复”和“取消”的简单 Agent,体会这些操作对状态管理的要求。你会发现,没有持久化和 Checkpoint,这些操作根本无法实现。
八大能力维度:生产级 Agent 的必修课#
框架 API 只是表象,底层能力才是关键。以下八个维度是评价任何 Agent 框架的标尺,也是需要系统学习的内容。
1. 执行模型(Execution Model)#
定义 Agent 的计算如何编排:谁拥有主循环?控制流由谁决定?
需要理解两层:
- Loop 承载方式:图式(LangGraph)、代码式(普通 SDK)、托管式(OpenAI Assistants)。
- 编排协议:ReAct(思考-行动-观察)、Plan-and-Execute(显式计划与进度)、对话式协作(Handoff、群聊)。 学习重点:不要押注某一种 loop,而是让状态管理、工具调用、流式输出独立于具体执行模型。
2. 状态管理(State Management)#
生产级 Agent 与玩具的分水岭。状态管理回答“Run 执行到一半时,哪些东西必须被保存,以及多个 Run 同时发生时如何保持一致”。
核心包括:状态表示、持久化、版本化、作用域。最关键的是 Checkpoint 机制:自动保存每一步状态,支持从任意节点恢复(时间旅行),处理并发冲突。LangGraph 是这方面的标杆。
学习重点:动手实现一个简单的 Checkpoint 机制,体会为什么仅仅保存 messages 不等于生产级状态管理。Agent 执行任务时,除了对话,还会调用工具、修改文件、更新数据库、触发外部 API。这些副作用(side effects)如果没有被记录,仅仅保存消息历史就无法还原执行现场。
3. 工具协议(Tool Protocol)#
工具协议定义 Agent 如何发现、调用和处理外部能力。这是最可能先标准化的部分。
- 定义与调用:JSON Schema 已成为事实标准。
- 发现机制:MCP(Model Context Protocol)将工具生态从框架内部抽离,一个 MCP Server 可以服务多个 Runtime。
- 错误处理:推荐 Error-as-Data——将工具错误作为合法结果返回给 LLM,让其自主决策重试、换工具或告知用户。 学习重点:封装一个 MCP Server,体验工具与框架解耦的好处;理解 Error-as-Data 与 Error-as-Exception 的取舍。
4. 流式输出(Streaming)#
流式输出不是 token 打字机,而是任务事件流。生产级流式输出需要支持:
- 粒度控制:Token 级、Step 级、Artifact 级。
- 可恢复性:断线重连后能从断点继续接收事件(Last-Event-ID)。
- 多通道:同时传递状态变更、消息增量、工具进展、产物增量、错误等不同类型事件。 学习重点:实现一个可恢复的 SSE 流,体验“先回放历史事件,再实时 tail”的机制。
5. 中断与恢复(Interrupt & Resume)#
这是 Human-in-the-Loop 的基础设施。真正的中断恢复需要与状态持久化深度整合:
- 中断触发:到达特定节点、工具审批、主动请求人类输入。
- 中断载荷:暴露给人类的结构化信息(问题、选项、草稿等)。
- 恢复机制:人类通过 Command 或消息提交输入,Runtime 从 Checkpoint 加载状态并注入输入,继续执行。 学习重点:实现一个审批场景,支持暂停数小时后恢复,并思考为什么没有持久化就无法做到这一点。
6. 错误恢复(Error Recovery)#
错误恢复回答“失败是否会抹掉已有进度”。两种策略:
- Error-as-Data:工具错误作为消息返回给 LLM,让模型自主处理。
- Checkpoint 回滚:从最近稳定状态恢复,只重试失败步骤。 学习重点:在项目中实践 Error-as-Data,并尝试利用 Checkpoint 实现局部重试。
7. 多 Agent 协作(Multi-Agent Collaboration)#
多 Agent 是最碎片化的方向,不宜过早押注。需要理解四种模式:子图嵌套、Handoff 接力、群聊选择、发布订阅。 学习重点:先做好单 Agent 的 Thread/Run/State/Tool/Event/Artifact 边界,再根据业务需要引入 Handoff 或 Subagent。
8. 可观测性与可评测性(Observability & Evaluability)#
看见问题与评价质量,二者相辅相成。
- 可观测性:Trace/Span、事件流、状态快照、成本归因。
- 可评测性:质量指标、归因分析、对比实验、反馈闭环。 目前所有框架中这是最薄弱的环节,需要格外重视。
学习重点:为你的 Agent 接入 Tracing,并设计一个评测集,统计 Pass Rate、Token 成本和延迟,尝试做归因分析。
学习路径#
从单 Agent 到生产级系统#
阶段 1:最小闭环(1~2 周)#
- 用任意语言实现一个 ReAct Agent,能调用 2~3 个工具。
- 理解 Run 状态机:创建、执行、完成。
- 产出:一个命令行 Agent,能回答简单问题并调用工具。
阶段 2:状态与恢复(2~3 周)#
- 学习 LangGraph 的 Checkpoint 机制,实现自动快照和从任意步恢复。
- 实现一个中断场景:工具审批,支持暂停数小时后恢复。
- 产出:一个能“暂停-恢复”的 Agent,状态持久化到数据库。
阶段 3:工具与流式(2~3 周)#
- 将业务工具封装为 MCP Server,并在 Agent 中调用。
- 实现可恢复 SSE 流式输出,支持断线重连。
- 产出:一个实时展示执行过程、且能断线恢复的 Agent。
阶段 4:观测与评测(2~3 周)#
- 接入 Tracing,记录每个 Step 的输入/输出、耗时、成本。
- 设计一个小型评测集,统计 Pass Rate 和 Token 成本,并对比不同 Prompt 的效果。
- 产出:一个带有 Trace 和评测脚本的 Agent 项目。
阶段 5:多 Agent 与协议设计(长期)#
- 尝试用 LangGraph 实现 Supervisor + Worker 模式,或用 OpenAI Agents SDK 实现 Handoff。
- 阅读 A2A、AG-UI 等协议规范,提炼共性。
- 产出:一份框架评估报告,或一个自定义的最小 Agent Protocol 设计。
如何选择框架和学习资源#
选择框架的原则:
- 不要因为流行而学,而是根据项目需求选择能补齐短板的框架。
- 如果看重状态管理和中断恢复,LangGraph 是首选。
- 如果快速原型和托管体验,OpenAI Agents SDK 更方便。
- 如果研究多 Agent 事件驱动,AutoGen Core 值得一看。
学习资源推荐:
- 官方文档:LangGraph、OpenAI Agents SDK、MCP。
- 协议规范:A2A、AG-UI(了解行业收敛方向)。
- 实践文章:关注上下文工程、OneAgent 范式等,理解长任务 Agent 的设计模式。
结语:框架会变,协议对象稳定#
Agent 领域还处于快速演进期,新的框架和概念会不断涌现。但如果你掌握了上述核心对象、生命周期操作和八大能力维度,就能在新框架出现时快速判断:
- 它只是换了一套 API 名字,还是解决了一个真实的 Runtime 问题?
- 它强化的是执行模型、状态管理、工具协议,还是流式事件?
- 它是暴露底层能力,还是把整套长任务 Agent 体验封装成开箱即用的 harness? 学习 Agent 的本质,是学习如何设计一个可靠、可观测、可恢复的自主执行系统。 框架只是工具,而协议对象和 Runtime 能力才是你真正需要内化的知识。